Amazonbot: Wenn der Crawler von Amazon Ihren Server in die Knie zwingt
Auf den Servern, die wir betreuen, taucht Amazonbot in unseren Traffic-Analysen regelmäßig auf, neben anderen KI-Crawlern wie GPTBot oder meta-externalagent. Das ist keine grundsätzliche Haltung gegen KI: Wir haben ihn bei mehreren Lastspitzen beobachtet, bei denen der Crawler von Amazon die Logs anführte, auf Websites, denen er nie etwas gebracht hat.
Dieser Artikel erklärt, was Amazonbot tut, warum er Onlineshops so stark belastet, wie Sie ihn in Ihren Logs erkennen und welche Möglichkeiten Sie haben, ihn zu bremsen oder zu sperren.
Was genau ist Amazonbot?
Amazonbot ist der allgemeine Webcrawler von Amazon: Laut seiner offiziellen Seite dient er dazu, die Produkte und Dienste des Unternehmens zu verbessern, und kann zum Training seiner KI-Modelle verwendet werden. Ursprünglich als der Crawler vorgestellt, der Alexa mit Daten versorgt, ist er heute eindeutig ein Sammler von Trainingsdaten.
Amazon unterscheidet inzwischen drei Agenten, die sich in der robots.txt jeweils einzeln steuern lassen:
| Agent | Angegebener Zweck | KI-Training | Beachtet robots.txt |
|---|---|---|---|
| Amazonbot | Verbesserung von Produkten und Diensten | Ja, möglich | Ja |
| Amzn-SearchBot | Sucherlebnisse (Alexa usw.) | Nein | Ja; ohne eigene Regel folgt er den Regeln für andere Suchmaschinen |
| Amzn-User | Abruf in Echtzeit, um einem Nutzer zu antworten | Nein | Nicht immer, da die Aktion von einem Menschen ausgelöst wird |
Der User-Agent sieht aus wie ein gewöhnlicher Chrome, gefolgt von der Angabe compatible; Amazonbot/0.1. Amazon veröffentlicht die IP-Adressen jedes Agenten, sodass sich der echte Crawler von einem Betrüger unterscheiden lässt.
Ein Detail ist für einen Hosting-Anbieter besonders wichtig: Amazonbot unterstützt die Direktive Crawl-delay nicht. Man kann ihn also nicht einfach bitten, langsamer zu werden. Er beachtet dagegen Disallow, rel=nofollow sowie die Meta-Tags noindex und noarchive; Letzteres bedeutet bei Amazon „die Seite nicht für das Training verwenden“. Jede Änderung der robots.txt kann etwa 24 Stunden brauchen, bis sie berücksichtigt wird, und der Crawler kann sich auf eine bis zu 30 Tage alte Kopie im Cache stützen.
Die beobachteten Probleme
Der Hauptvorwurf an Amazonbot ist nicht, dass es ihn gibt, sondern dass er in Wellen kommt, ohne Vorwarnung und ohne Bremse. Wir sind nicht die Einzigen, denen das aufgefallen ist.
| Wer | Wann | Was geschah |
|---|---|---|
| Xe Iaso, Entwicklerin | Januar 2025 | Ihr selbst gehosteter Git-Server wird unter dem Amazon zugeschriebenen Traffic instabil; schließlich schreibt sie Anubis, einen Anti-Bot-Filter mit Proof of Work (Ars Technica) |
| git.gmem.ca | Juni 2024 | Rund 25.000 Anfragen von Amazonbot in weniger als 24 Stunden auf einer kleinen Git-Forge gesperrt |
| Hypernode, E-Commerce-Hoster | Mai 2023 | Mehrere Onlineshop-Server, bei denen mehr als 10 % der Rechenleistung auf Amazonbot entfielen; Traffic von Woche zu Woche stark schwankend |
| Discourse-Forum | 2021 | 39.649 Anfragen von Amazonbot gegenüber 457 vom nächsten Besucher; rund zehn AWS-IPs mit jeweils mehr als 1.000 Anfragen an einem Tag; der Autor vermutet am Ende einen Betrüger |
Diese Fälle haben eines gemeinsam: Der Crawler nimmt sich die Seiten vor, deren Erzeugung am teuersten ist. Bei einer Git-Forge sind das die Commit-Historie und die blame-Ansichten. Bei einem WooCommerce- oder PrestaShop-Shop sind es die Facettenfilter: Jede Kombination aus Farbe, Größe, Preis und Marke erzeugt eine eigene URL, also eine praktisch unendliche Zahl von Seiten.
Ein Crawler, der ohne Tempolimit allen Links folgt, durchsucht dann Tausende von Kombinationen, die nie jemand aufrufen wird. Jede davon umgeht den Seitencache, da die URL einmalig ist, und löst eine PHP-Anfrage und mehrere SQL-Abfragen aus.
Ein echter Fall: Amazonbot in der JetBlog-Paginierung gefangen
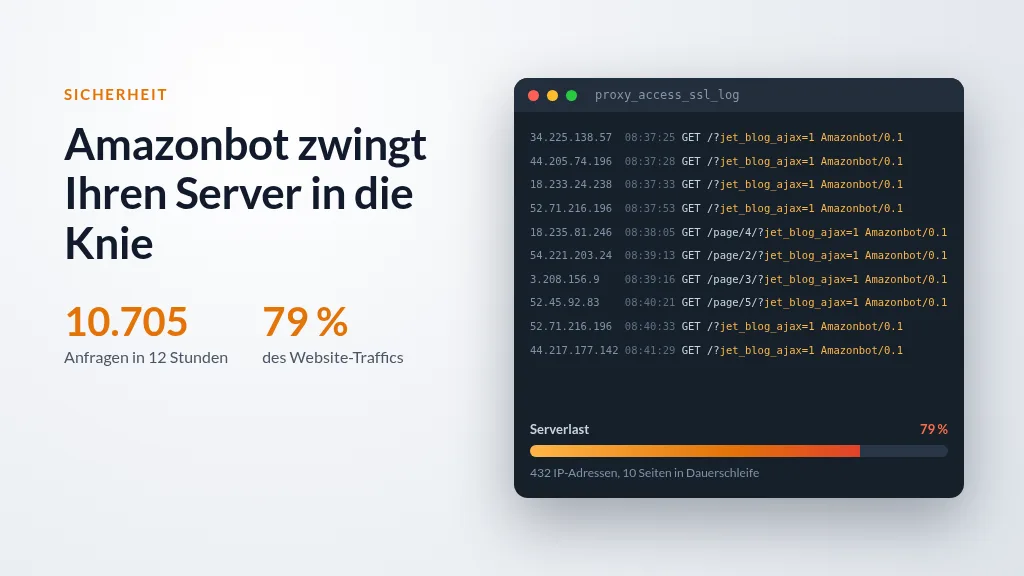
Anfang Oktober 2026 drehte sich Amazonbot auf einer von uns gehosteten WordPress-Website in der Paginierung eines Blogs im Kreis. In 12 Stunden am 5. Oktober schickte er 10.705 Anfragen von 432 IP-Adressen, also 79 % des gesamten Traffics der Website. Das Karussell drehte sich am nächsten Tag weiter; hier ein gekürzter Auszug aus dem Zugriffslog vom 6. Oktober (die Website ist nicht zu sehen, der User-Agent ist abgekürzt):
34.225.138.57  [06/Oct/2026:08:37:25] "GET /?jet_blog_ajax=1&nocache=1791224346&s"        200 32057 "-" "…Amazonbot/0.1…"
44.205.74.196  [06/Oct/2026:08:37:28] "GET /?jet_blog_ajax=1&nocache=1791228922&s"        200 32057 "-" "…Amazonbot/0.1…"
18.233.24.238  [06/Oct/2026:08:37:33] "GET /?jet_blog_ajax=1&nocache=1791120571&s"        200 32056 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:37:53] "GET /?jet_blog_ajax=1&nocache=1791224758&s"        200 32057 "-" "…Amazonbot/0.1…"
18.235.81.246  [06/Oct/2026:08:38:05] "GET /page/4/?jet_blog_ajax=1&nocache=1791241950&s" 200 31720 "-" "…Amazonbot/0.1…"
54.221.203.24  [06/Oct/2026:08:39:13] "GET /page/2/?jet_blog_ajax=1&nocache=1791241202&s" 200 31618 "-" "…Amazonbot/0.1…"
3.208.156.9    [06/Oct/2026:08:39:16] "GET /page/3/?jet_blog_ajax=1&nocache=1791240922&s" 200 31948 "-" "…Amazonbot/0.1…"
52.45.92.83    [06/Oct/2026:08:40:21] "GET /page/5/?jet_blog_ajax=1&nocache=1791241462&s" 200 30055 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:40:33] "GET /?jet_blog_ajax=1&nocache=1791213591&s"        200 32056 "-" "…Amazonbot/0.1…"
44.217.177.142 [06/Oct/2026:08:41:29] "GET /?jet_blog_ajax=1&nocache=1791126368&s" 200 32057 "-" "…Amazonbot/0.1…"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot) Chrome/119.0.6045.214 Safari/537.36| Messwert (5. Oktober, 8 bis 20 Uhr) | Wert |
|---|---|
| Anfragen von Amazonbot | 10.705, also im Schnitt eine alle 4 Sekunden |
| Anteil am gesamten Traffic der Website | 79 % (10.705 von 13.611 Anfragen) |
| Davon JetBlog-Paginierung | 100 % |
| Gleichmäßigkeit | Zwischen 887 und 896 Anfragen pro Stunde, höchstens 16 in einer Minute |
| Verschiedene IP-Adressen | 432; die aktivste schickte in 12 Stunden nur 52 Anfragen |
| Tatsächlich unterschiedliche Seiten | 10: die Startseite und die Seiten 2 bis 5 des Blogs, die Referenzseite und ihre Seiten 2 bis 4, eine Vorstellungsseite |
| Antworten | 100 % HTTP 200 |
| Ausgelieferte Datenmenge | 323,6 MB, also rund 30 KB pro Anfrage |
| Hochrechnung auf 24 Stunden bei diesem Tempo | Rund 21.000 Anfragen und 650 MB |
| Mit der offiziellen Amazonbot-Liste abgeglichene IPs | 58 von 58 im Auszug vom 6. Oktober (Liste vom 8. September 2026) |
Was dieser Auszug zeigt
Es ist wirklich Amazonbot, kein Betrüger. Alle IPs des Auszugs stehen in der von Amazon veröffentlichten Liste. Der offizielle Crawler eines multinationalen Konzerns kann also ganz allein diese Art von Traffic erzeugen.
Der Crawler ist in eine Falle mit unendlich vielen URLs getappt. Das Blog-Modul JetBlog (Crocoblock-Suite für Elementor) lädt seine Paginierung per AJAX. Seine Links tragen jet_blog_ajax=1 und einen Parameter nocache, der sich bei jeder Anzeige ändert. Für einen Crawler ist jeder Wert eine neue Seite: Er fordert endlos dieselben zehn Seiten unter verschiedenen Namen an, im Takt eines Metronoms. Die Werte von nocache sehen übrigens wie Zeitstempel der Vortage aus, ein Zeichen dafür, dass der Crawler Links wiederverwendet, die er bei früheren Besuchen gesammelt hat.
Der Cache nützt nichts. Da jede URL einmalig ist, wird keine Antwort aus dem Cache ausgeliefert: Alle 10.705 Anfragen der 12 Stunden wurden von PHP und MySQL berechnet, nur um immer wieder dieselben zehn Seiten zurückzugeben.
Eine Sperre nach IP ist zwecklos. Bei 432 Adressen in 12 Stunden schickte die aktivste IP nur 52 Anfragen, kaum mehr als 4 pro Stunde. Ein Fail2ban oder ein Ratenlimit pro IP sieht nichts Ungewöhnliches; nur die Signatur der Anfrage, also User-Agent oder Form der URL, ermöglicht eine Reaktion.
Was wir umgesetzt haben
Statt Amazonbot zu sperren, haben wir die Ursache behoben: Eine Regel in der Web Application Firewall entschärft diese Falle für alle Crawler. Eine JetBlog-Paginierung, die ohne den AJAX-Header X-Requested-With angefordert wird, was kein Browser tut, wird per 301 auf die saubere URL umgeleitet. Der Crawler landet dann auf einer einzigen Adresse, die aus dem Cache ausgeliefert wird.
Warum das für einen Hosting-Anbieter so teuer ist
Auf einem Shared-Hosting-Server bremst ein Crawler, der auf einer Website außer Kontrolle gerät, alle anderen aus. PHP-Prozesse, MySQL-Verbindungen und Arbeitsspeicher werden geteilt: Ein paar Tausend in einer Stunde erzeugte Facettenseiten genügen, um die Antwortzeiten Dutzender Websites zu verlängern, die nichts damit zu tun haben.
Drei Faktoren verschärfen den Fall Amazonbot:
- Kein
Crawl-delay. Die einzige Standardeinstellung, um um ein langsameres Tempo zu bitten, wird ignoriert. Es bleibt nur das schlichte Verbot, teilweise oder vollständig. - Nur dynamische Seiten. Ein Crawler lädt weder Bilder noch CSS noch JavaScript; er fordert nur HTML an, also den teuersten Teil.
- Keine Gegenleistung. Anders als Googlebot oder Bingbot bringt Amazonbot einem typischen europäischen Onlineshop keine messbaren Besucher. Die Serverkosten sind real, der Nutzen bleibt hypothetisch.
Dieses Ungleichgewicht, mehr noch als das reine Volumen, rechtfertigt es, ihn getrennt von den klassischen Suchmaschinen zu behandeln.
Ihn in den Logs erkennen
Amazonbot gibt sich über seinen User-Agent ehrlich zu erkennen: Eine einfache Suche nach dem Wort Amazonbot in den Zugriffslogs reicht für eine erste Messung. Auf einem Plesk-Server liegen die Logs unter /var/www/vhosts/system/<domain>/logs/; wenn nginx als Proxy vor Apache arbeitet, lesen Sie die Dateien proxy_access*.
Die von Amazonbot am häufigsten besuchten Websites:
for d in /var/www/vhosts/system/*/; do
  n=$(cat "$d"logs/*access_ssl_log 2>/dev/null | grep -c Amazonbot)
  [ "$n" -gt 0 ] && echo "$n $(basename "$d")"
done | sort -rn | head
Das Tempo Stunde für Stunde auf einer Website, um die Wellen zu erkennen:
grep Amazonbot /var/www/vhosts/system/example.com/logs/proxy_access_ssl_log \
  | awk '{print substr($4, 2, 14) "h"}' | uniq -c | tail -24
Echter Crawler oder Betrüger?
Jeder kann „Amazonbot“ in einen User-Agent schreiben, und viele bösartige Bots laufen auf gemieteten AWS-Servern, also mit IPs, die Amazon gehören. Eine „Amazon“-IP beweist nichts: Der Discourse-Fall von 2021 kam von EC2-IPs, und sein Autor kam zu dem Schluss, dass es sich um einen Betrüger handelte.
Zwei zuverlässige Prüfungen:
- Die IP mit der von Amazon veröffentlichten Liste vergleichen.
- Eine umgekehrte DNS-Abfrage durchführen: Der echte Crawler antwortet mit einem Namen auf
crawl.amazonbot.amazon, den man anschließend mit einer normalen Abfrage bestätigt.
host <verdächtige IP>       # muss ...crawl.amazonbot.amazon liefern
host <gelieferter Name>     # muss dieselbe IP liefern
Diese Unterscheidung ist wichtig: Ein Betrüger ignoriert die robots.txt, und nur eine Sperre auf dem Server hält ihn auf.
Die Gegenmaßnahmen, von sanft bis entschlossen
1. Die robots.txt, Website für Website
Das ist die höfliche Methode, und Amazon verpflichtet sich, sie für Amazonbot zu beachten. Sie schützt nur vor dem echten Crawler und braucht bis zu 24 Stunden, bis sie greift.
Die gesamte Website sperren:
User-agent: Amazonbot
Disallow: /
Oder nur die Facetten, während die Produktseiten erreichbar bleiben:
User-agent: Amazonbot
Disallow: /*?*filter_
Disallow: /*?*pa_
Disallow: /*?*min_price=
Disallow: /*?*q=
Um die Nutzung Ihrer Texte für das Training abzulehnen, ohne das Crawling zu sperren, erkennt Amazon außerdem das Tag <meta name="robots" content="noarchive">.
2. ModSecurity, auf Serverebene
Die robots.txt gilt nur für Crawler, die sie beachten, und sie muss für jede Website einzeln geändert werden. Die Web Application Firewall ModSecurity setzt früher an: Sie lehnt eine Anfrage anhand ihres User-Agents oder der Form ihrer URL ab, bevor WordPress oder PrestaShop überhaupt aufgerufen werden. Eine in diesem Stadium gesperrte Anfrage kostet den Server fast nichts, und Betrüger, die sich als Amazonbot ausgeben, werden ebenfalls gestoppt.
Auf einem Plesk-Server lässt sich diese Einstellung Domain für Domain anwenden, um eine bestimmte Website zu schützen, ohne die anderen anzutasten, oder global für alle gehosteten Websites. Die richtige Ebene hängt von Ihren Websites und deren Traffic ab: Besprechen Sie das mit unserem technischen Team, das anschließend in den Logs prüft, ob die Einstellung die gewünschte Wirkung hat.
3. Achten Sie auf Ihren Code: keine schwarzen Löcher für Crawler
Der Fall JetBlog zeigt es: Das Problem lag nicht nur am Crawler, sondern an einem Modul, das endlos URLs erzeugte. Für einen Crawler ist jeder neue Link eine neue Seite, die er besuchen muss. Eine Website, die solche Links ohne Ende erzeugt, wird zu einem schwarzen Loch, das ihn ansaugt, und jeder Durchgang wird mit Serverressourcen bezahlt.
Die häufigsten Quellen schwarzer Löcher:
- Anti-Cache- oder Zeitstempel-Parameter in Links, wie das
nocacheder AJAX-Paginierung von JetBlog; - Facettenfilter von WooCommerce oder PrestaShop, deren Kombinationen in die Tausende gehen;
- Kalender und Archive, in denen man endlos Monat für Monat weiterblättern kann;
- interne Suchseiten, die über einen Link erreichbar sind, auch mit einer leeren Suche (
?s=).
Oft genügen ein paar Handgriffe: in den Logs nachsehen, welche URLs die Crawler tatsächlich besuchen, Adressen, die nur für AJAX gedacht sind, nicht als normale Links anbieten, diese Links mit rel="nofollow" kennzeichnen, das Amazonbot beachtet, und ihre Muster in der robots.txt sperren:
User-agent: *
Disallow: /*jet_blog_ajax=
Disallow: /*?*filter_
In unserem Fall hätte, da es sich um den echten Amazonbot handelte, die erste dieser Zeilen genügt, damit er die JetBlog-Paginierung aufgibt, mit der von Amazon angekündigten Verzögerung von rund 24 Stunden.
Sperren oder nicht?
Eine Sperre von Amazonbot hat keinerlei Auswirkung auf das Ranking bei Google oder Bing, was sie für die meisten Websites zu einer Entscheidung mit geringem Risiko macht. Dennoch gibt es Argumente für beide Seiten.
| Sperren | Durchlassen |
|---|---|
| Geringere Serverlast, vor allem bei Shops mit Facettennavigation | Mögliche Sichtbarkeit in den Antworten von Alexa und den KI-Diensten von Amazon |
| Inhalte werden nicht zum Training von Modellen wiederverwendet | Programm Amazon Content Partners: ein kleiner Bonus auf die Affiliate-Provision und Hosting-Guthaben für Websites, die es erlauben |
| Kein messbarer Traffic-Verlust für eine typische europäische Website | Eine Sperre nach User-Agent hält Betrüger nicht auf, die ohnehin andere Abwehrmaßnahmen erfordern |
Für eine Amazon-Affiliate-Website oder ein Medium, das auf Sprachsuche setzt, ist eine Teilsperre, beschränkt auf Facetten und Suchseiten, ein guter Kompromiss. Für einen Shop auf einem Shared-Hosting-Server bleibt die vollständige Sperre die einfachste Wahl.
Kurz gesagt
Amazonbot ist kein Hacker: Er gibt sich zu erkennen, veröffentlicht seine IPs und beachtet die robots.txt. Aber er kennt kein Tempolimit, nimmt die teuersten Seiten ins Visier und bringt den besuchten Websites so gut wie nichts. Messen Sie zuerst seinen Anteil in Ihren Logs, prüfen Sie, ob es wirklich er ist, und wählen Sie dann zwischen einer gezielten robots.txt und einer Sperre auf dem Server. Und wie auch immer Sie sich entscheiden: Schützen Sie Ihre Facetten, denn der nächste Crawler ist vielleicht nicht so höflich.
Bei HaiSoft überwachen wir den Traffic der Websites, die wir hosten, und der Server, die wir betreuen. Belastet ein Crawler Ihre Website, oder sind Sie unsicher, welche Gegenmaßnahme die richtige ist? Kontaktieren Sie unser technisches Team.
Quellen
- Amazon Developer: About Amazonbot
- Amazon Developer: IP-Adressen von Amazonbot
- Xe Iaso: Amazon's AI crawler is making my git server unstable
- Ars Technica, über Harvard TagTeam: Devs say AI crawlers dominate traffic
- Hypernode: How Amazon's web crawler could impact the performance of your online store
- Discourse Meta: Amazonbot abusive crawling
- SegmentFault: Zusammenfassung des Beitrags von git.gmem.ca